OpenAI 的 FDE 意味着什么(全文翻译)
我们做什么、如何工作,以及如何解决企业最棘手的问题,带来实际影响。
原作者:Colin Jarvis,OpenAI 前沿部署工程(Forward Deployed Engineering,FDE)负责人。
原文发布日期:2026 年 10 月 22 日。
译文说明:基于保存的原文 HTML 翻译正文,保留原文第一人称、案例链接和全部正文配图;文中的“我”“我们”指原作者及 OpenAI 团队。配图从 HTML 提取并保存至本站,图中文字保留英文,另附中文图注;图片来源均为 OpenAI 原文。HTML 未包含视频文件,因此保留视频封面及原文观看链接。未收录网页导航和推荐阅读。原文在第二节重复描述了同一个部署案例,译文合并为一次表述。
Codex 推出时,团队里有人问我:“如果 Codex 一次就能完成我们过去几个月一直在构建的那些用例,我们该做什么?”
这个问题触及了 FDE 在 OpenAI 的核心意义。我们与客户并肩工作,理解他们最棘手的问题,构建他们可以信赖的解决方案。我们在这个过程中学到的东西,会帮助塑造产品,也会为研究团队提供具体的待解问题。
这就是进步。如果每隔几个月,我们就让自己的某些工作变得不再必要,那就说明 FDE 团队做对了。
我在 2025 年初组建了这支团队,目的是弥合我们所说的“部署鸿沟”:模型看起来具备的能力,与人们能够可靠地用来完成工作的能力之间的距离。
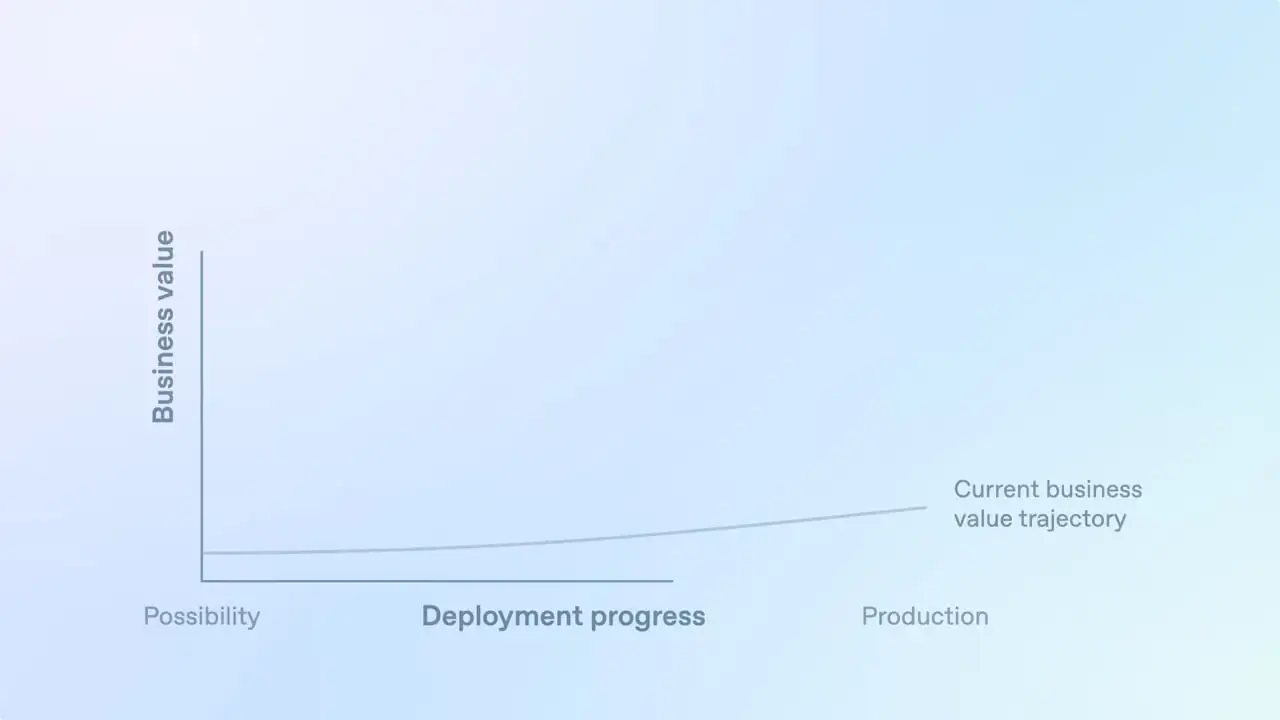
图注:横轴为部署进程,从技术可能性走向生产;纵轴为业务价值,曲线表示当前业务价值的发展轨迹。这是原文 14 秒动画的封面,前往原文观看动画。
模型能力的发展速度,已经超过了让这些能力真正投入使用所需的系统和流程。有时,缺的是一个产品;有时,模型在基准测试中表现很好,却无法应对现实中的变量和约束,完成实际工作。
我们聚焦客户最难的问题。如果现有模型已经能胜任,我们就与产品团队和客户合作,让解决方案可以复用;如果模型还做不到,我们就与客户和研究团队一起明确差距,推动改进。我们的目标是,让每一次合作都为下一位客户提供更好的起点。如果我们把基础能力提升到客户下次无需 FDE 就能解决同类问题的程度,那就说明我们做得很好。
对于拥有 200 年历史的农业企业 John Deere(约翰迪尔)来说,挑战在于如何大规模地为农民提供个性化建议。
See & Spray 就是一个例子。这项精准除草技术利用摄像头和机器学习识别杂草,并进行定点喷洒,而不是对整块田地施药,最多可以减少 70% 的化学药剂用量。
但要真正获得这些收益,农民需要知道如何配置这项技术、规划农季,并随着条件变化调整作业方式。
John Deere 部署了 OpenAI 的 API,帮助这类支持服务实现个性化和规模化。
AI 可以用自然语言回答农民的问题,提供有针对性的设置指导和建议,识别设备可能尚未充分发挥效能的情况,并帮助农民理解这项技术带来的价值。
这里的机会不局限于某一次交互,而是在整个客户旅程中提供相关指导,帮助农民更好地使用设备,同时提高效率和可持续性。
这正是 OpenAI FDE 致力于解决的挑战:帮助组织把 AI 能力转化为系统,使其在复杂的现实环境中创造实际价值。
但这些问题往往高度开放,可能没有既定的标准答案,也没有现成的方法手册。每个人都想创造前所未有的东西,愿意为此付诸必要行动的人却少得多。
要找到优秀的 FDE,同时不断提高“足够好”的标准,就必须持续实验,并将其付诸实践。
从结果出发
每次 FDE 团队会议开始时,我都会展示一页幻灯片,上面写着一条核心价值观:“从结果出发,为成功做一切必要的事,然后再实现规模化。”
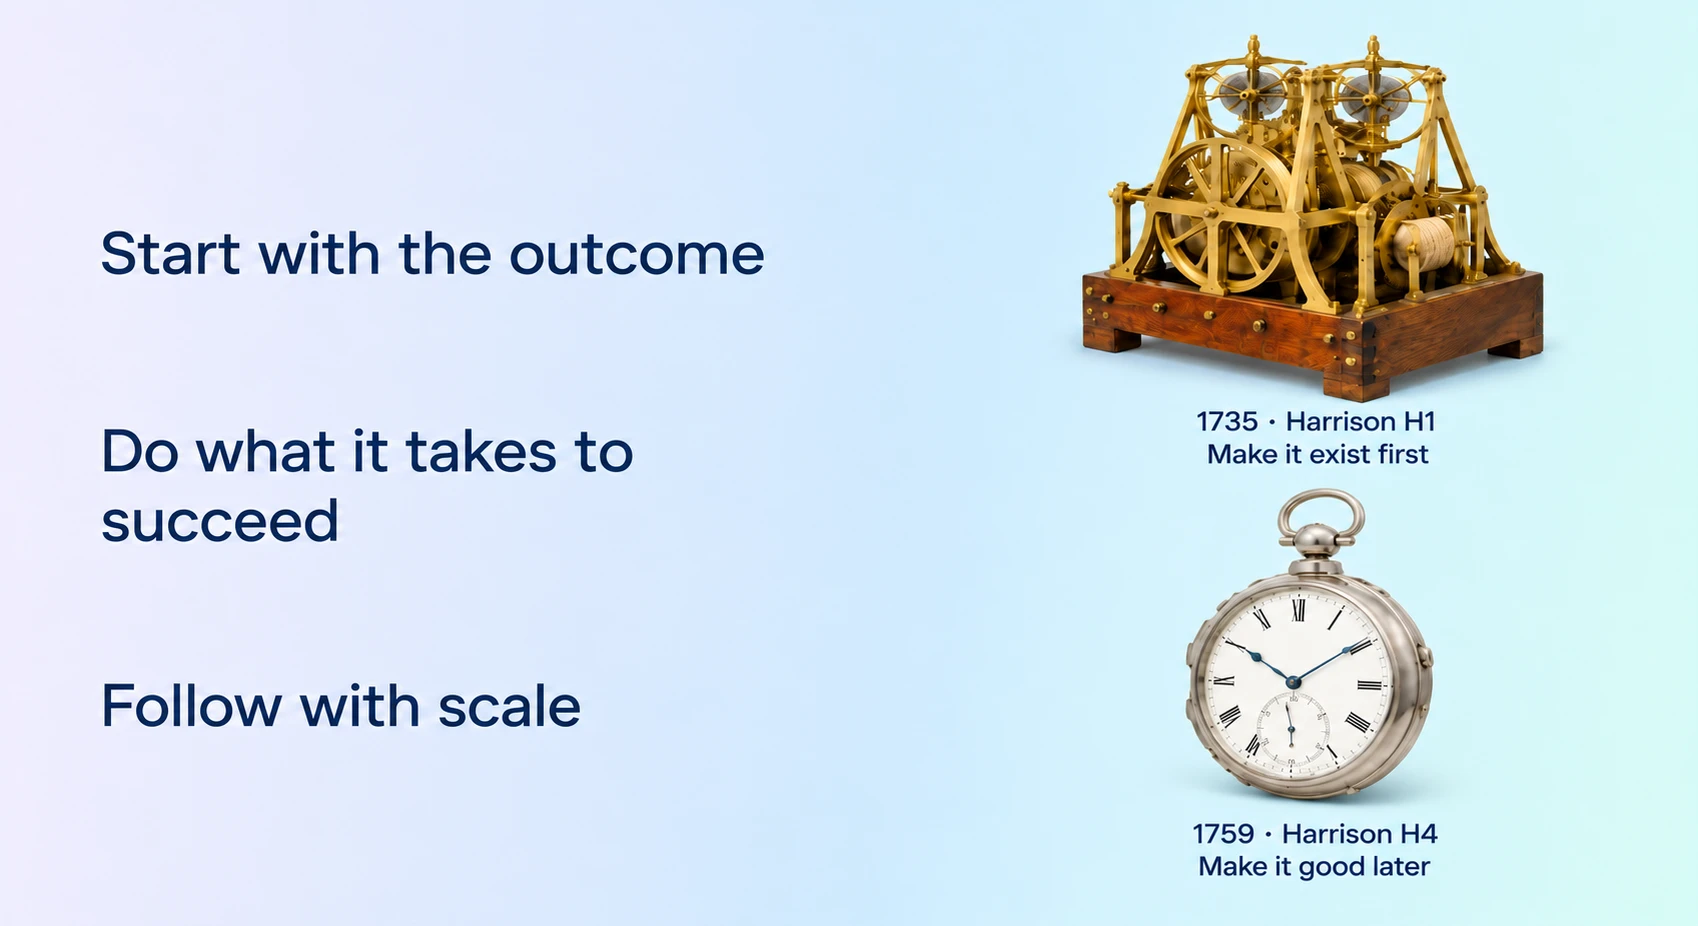
图中文字:从结果出发;为成功做一切必要的事;随后实现规模化。右侧以 Harrison H1(1735 年)和 H4(1759 年)为例:先让它存在,再把它做好。
一个令人印象深刻的演示,可能已经获得了很多认可,才有人开始追问它在现实中是否真的有效。
我们的工作,是以我们敢于在生产环境中负责的标准,解决客户的问题。
2025 年年中,我们约有 15 名 FDE 与一家大型半导体客户合作,推进 10 多个用例。目标是让他们的验证流程实现 AI 原生化,覆盖以下方面:
- 定向测试生成。
- 根因分析与调试。
- 架构助手。
在这个行业,验证可能占一个项目约 70% 的工作量。这里的机会非常大,可以切入的地方也很多。
一些 FDE 加入 OpenAI 才几天,此前从未在半导体行业工作过。他们深入客户的验证团队,利用业余时间学习芯片设计,并与工程师共同构建评估,检验 AI 能否生成有用的测试,以及能否正确诊断芯片故障。
在学习的同时,我们也为各个用例构建了定制的运行框架(harness)。在最初的 3 至 6 个月里,这些用例全部进入生产环境,并开始被早期用户采用。回报体现在这些指标上:
- 基于 AI 的定向测试生成节省了约 48% 的时间。
- 通过计算内核优化,性能提升的中位数达到 22%。
- 原本需要数周的调试工作,被压缩到数小时。
当我们向首席硬件官汇报这些成果时,他问道:“你们来这里之前,是不是做过芯片设计师?”
我们的 FDE 不必在第一天就了解这个行业,但学习行业知识是他们的责任。
随着编程助手加快软件构建速度,理解客户业务变得更加重要。我们在组建团队时,会将通才与领域专家搭配起来。
你既需要足够的知识来作出合理判断,也需要足够的好奇心,去质疑人们对于现状的既有假设。
例如,在生命科学领域,我们 FDE 的科研背景,帮助他们赢得了从事临床前药物发现工作的研究人员的信任。这些工作包括靶点验证与优先级排序、基因表达分析,以及化学合成路线重建。这样的专业知识,使他们能够对如何改进这些工作流程提出有依据的判断。
让成功可以复用
我们已经证明,这些工作流程能够创造价值,但要将其中任何一个推广到另一个团队,仍然需要过多的定制集成。接下来的挑战,是在保留这些成果的同时,让软件更容易部署和维护。
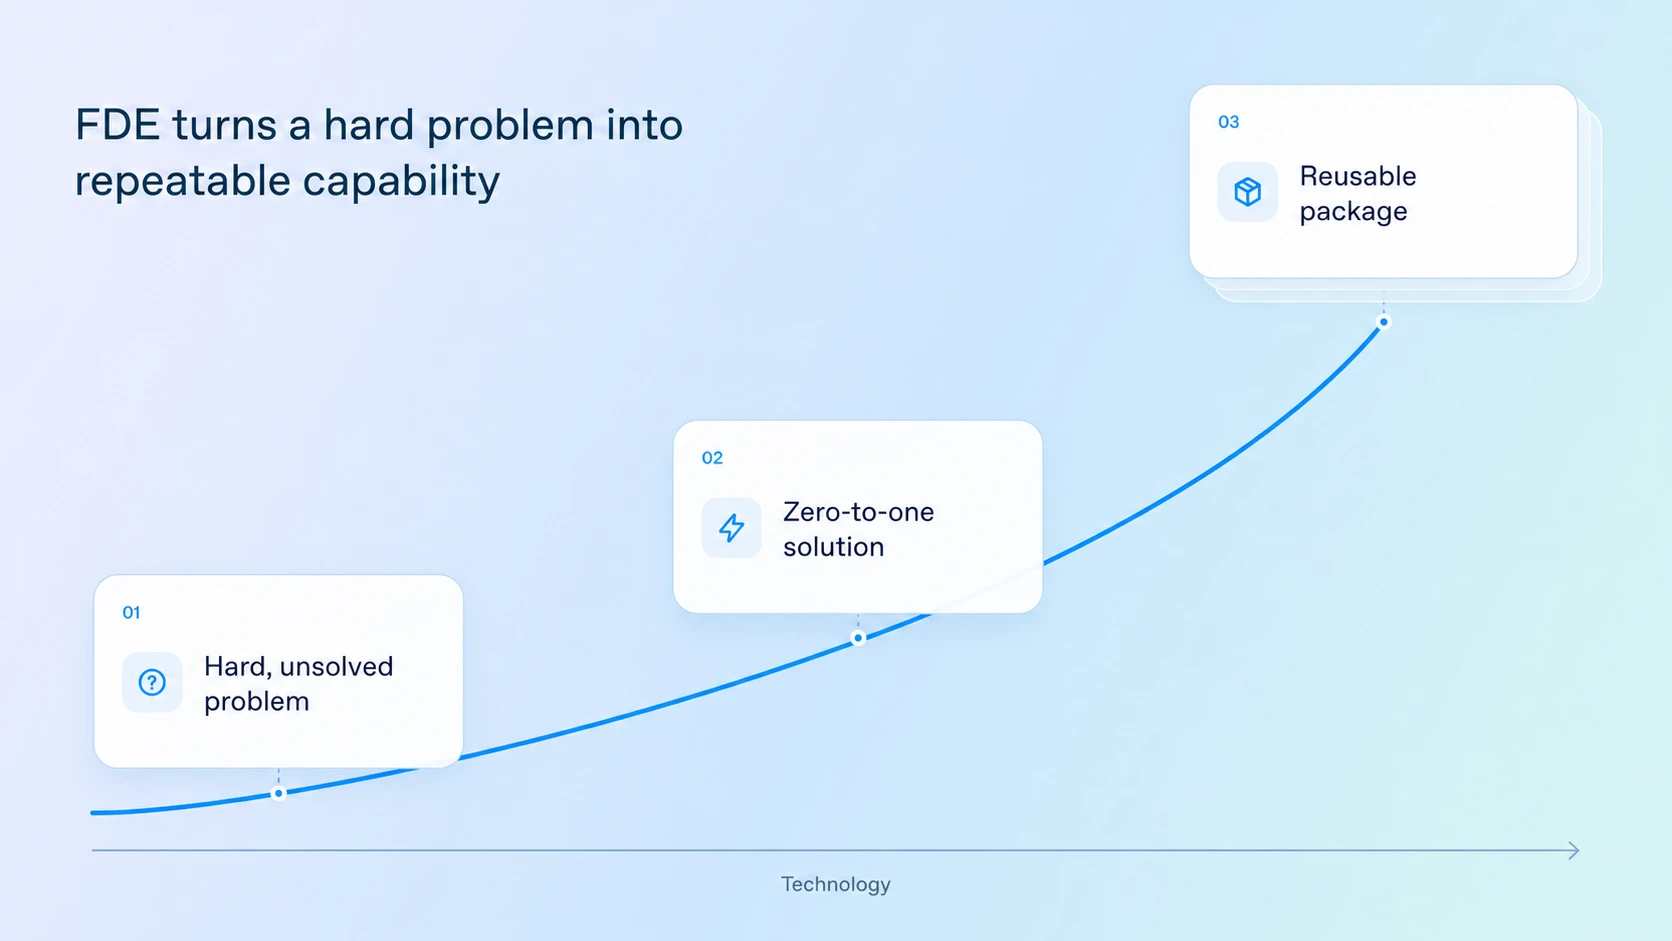
图中文字:FDE 将难题转化为可重复使用的能力。随着技术发展,依次经历“尚未解决的难题”“从零到一的解决方案”“可复用的封装”。
到那时,Codex 的能力已经有了提升。一位 FDE 尝试围绕 Codex 重建自己的应用,随后与团队合作,将这些用例迁移到以 Codex 为核心的共用运行框架上。
定制应用变成了基于 Codex 通用基础能力构建的插件和技能。Codex 也成为交互界面,让我们得以停用此前为各个用例分别编写的终端界面和命令行工具。
我们得以移除每个项目中约 90% 的定制代码,这改变了我们构建、维护和扩展这些工作流程的方式:
- 我们可以直接受益于 Codex 的统一改进,减少每个用例所需的胶水代码。
- 关键功能被封装为技能和插件,更容易相互共享,也方便 AI 卓越中心(AI CoE)集中管理。这意味着,从一个团队推广到另一个团队,可能只需要换上新的连接器或 MCP 服务器、构建新的评估,然后就能开始运行——我们甚至也有用于构建评估的技能。
- 在 2026 年 8 月的一个案例中,首次部署花了两个月,而将方案推广到第二个团队只用了一天。随着推广规模扩大,后续团队的接入速度还在加快。
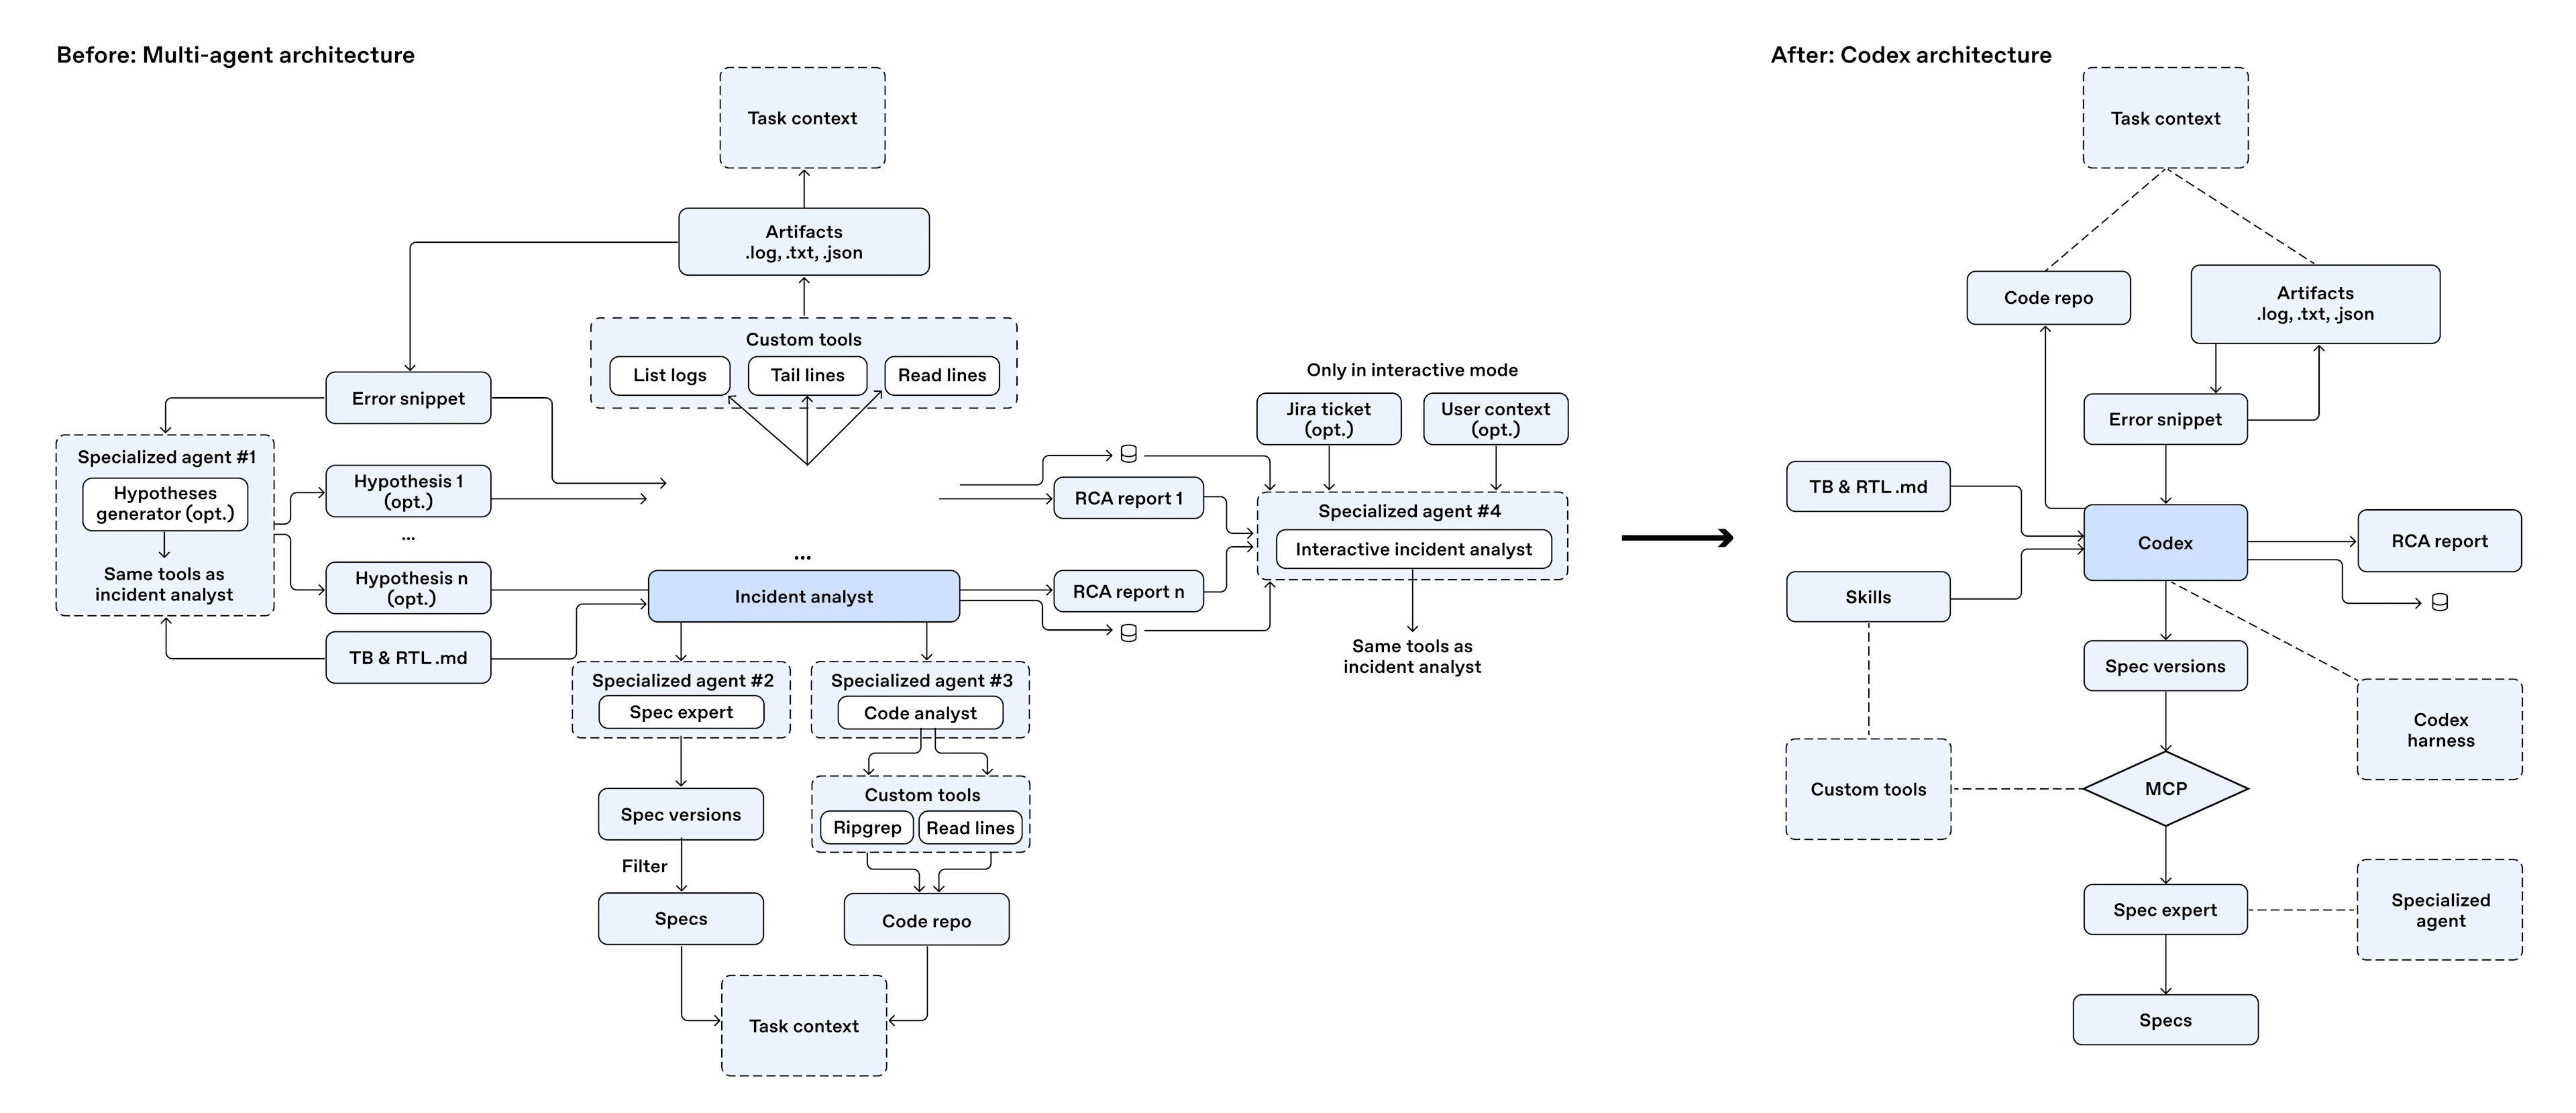
图注:左侧是由假设生成、规范分析、代码分析和交互式故障分析等专用智能体组成的架构,配有读取日志、检索代码等定制工具;右侧改为以 Codex 为核心,结合 Skills、代码仓库、任务上下文和 MCP 访问规范及专用智能体,输出根因分析报告(RCA report)。图中的 TB 与 RTL 分别指测试平台和寄存器传输级设计;Artifacts 指日志、文本、JSON 等产物;opt. 表示可选。
这就是让自己的某些工作不再必要的一种方式。此前为实现生产部署所做的工作,让我们确认了真正重要的东西。随着底层产品不断改进,我们可以替换掉大量定制实现,同时保留它们创造的价值。
这也是为什么顺序很重要。大语言模型让我们能够快速构建。应当利用这种速度,把有价值的东西交到用户手中,了解哪些方案经得起实践检验,然后再推广有效的方案。
同样的原则适用于所有合作项目。
OpenAI Presence 是我们面向企业语音和聊天智能体的产品,它源于真实的客户部署。这项工作从 Swarm 起步,经过 Agents API 的演进,发展至今,已有一家客户使用 AI 处理超过一半的来电。
将这些系统投入生产,让我们了解了哪些问题需要定制方案,哪些基础组件能够供其他团队复用。我们把这些组件纳入 Presence,使开发者更容易自动化那些受监管的工作流程,而不必重新构建底层基础设施。每一次部署都帮助塑造了产品,也为下一位客户提供了更好的起点。
在与 Thrive Holdings 的合作中,OpenAI 的 FDE 和研究人员与工程师、会计师并肩工作,为 Crete 旗下的会计师事务所构建了 Tax AI。在试点期间,Tax AI 处理了 7,000 份纳税申报表,使处理量提升了约 50%。
其中最困难的挑战之一,是将出租房产相关的纳税申报自动化。这项工作经过六周的工程开发和专业人员审核,才使精确率与召回率都达到 90%。由此形成的可复用模式,让 Tax AI 更容易扩展到其他复杂的税务附表。
目前,这些团队正将同样的方法应用于记账、审计和 IT 支持,构建能够通过专业人员反馈和实际使用不断改进的系统。
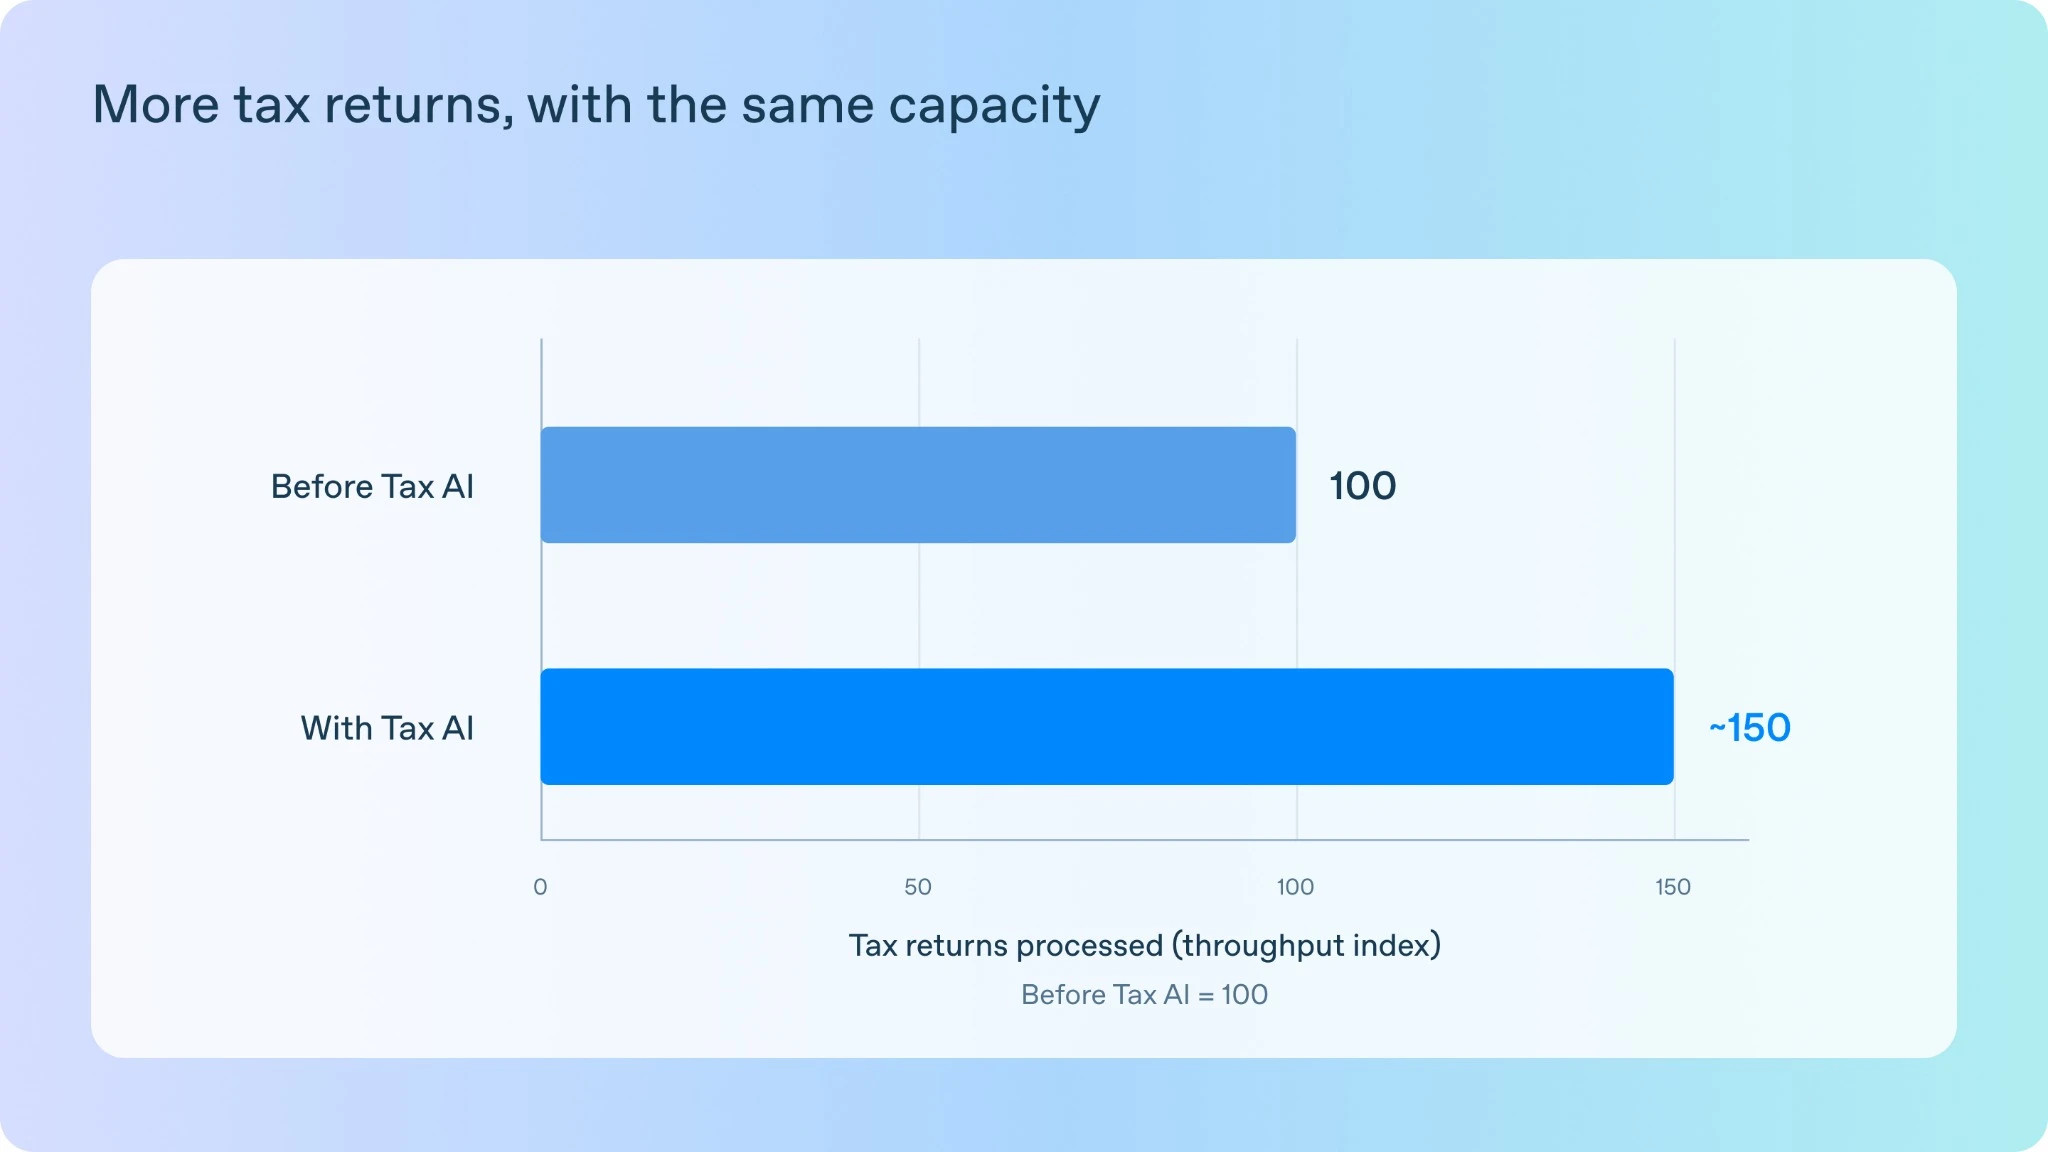
图中文字:以相同的处理能力完成更多纳税申报。将使用 Tax AI 前的处理量设为指数 100,使用后约为 150,即提高约 50%。
在能力缺口出现时弥合它们
有时,更好的产品能让我们简化已构建的系统;但有时,模型本身还无法完成任务。
如果我们只构建当下模型已经能支持的东西,就无法发现研究团队接下来需要弥合的智能能力缺口。因此,我们许多重要的合作项目,都是从这些能力边界出发,由客户、FDE 和研究团队共同承诺,一起攻克问题。
我们此前已经与一家大型电信客户开发了客服平台,他们希望进一步将其扩展到语音场景。
语音约占这家客户客服业务量的 90%。相比聊天,要在自动化服务中完成这些请求的处理、避免转交人工,成本更高;要让口音处理、语气,以及延迟和准确性达到生产要求,也带来了一系列新的技术挑战。做好这件事,会对他们的业务产生显著影响。
在确定项目范围时,我们用来判断模型能否胜任生产任务的关键评估,其得分只有约 60%。我们已经触及模型的能力边界。模型在客服场景下的函数调用和指令遵循能力,都需要提高。
我们向客户说明了这一情况,并让研究团队参与进来。FDE 与客户共同构建平台,明确模型需要做到什么;研究团队则负责弥合能力缺口,通过连续推出的模型快照,让我们能够对照客户要求检验进展。
在六个月里,关键评估上的表现从约 60% 提升到 80%,再提升到 90% 以上,达到了生产环境所需的水平。
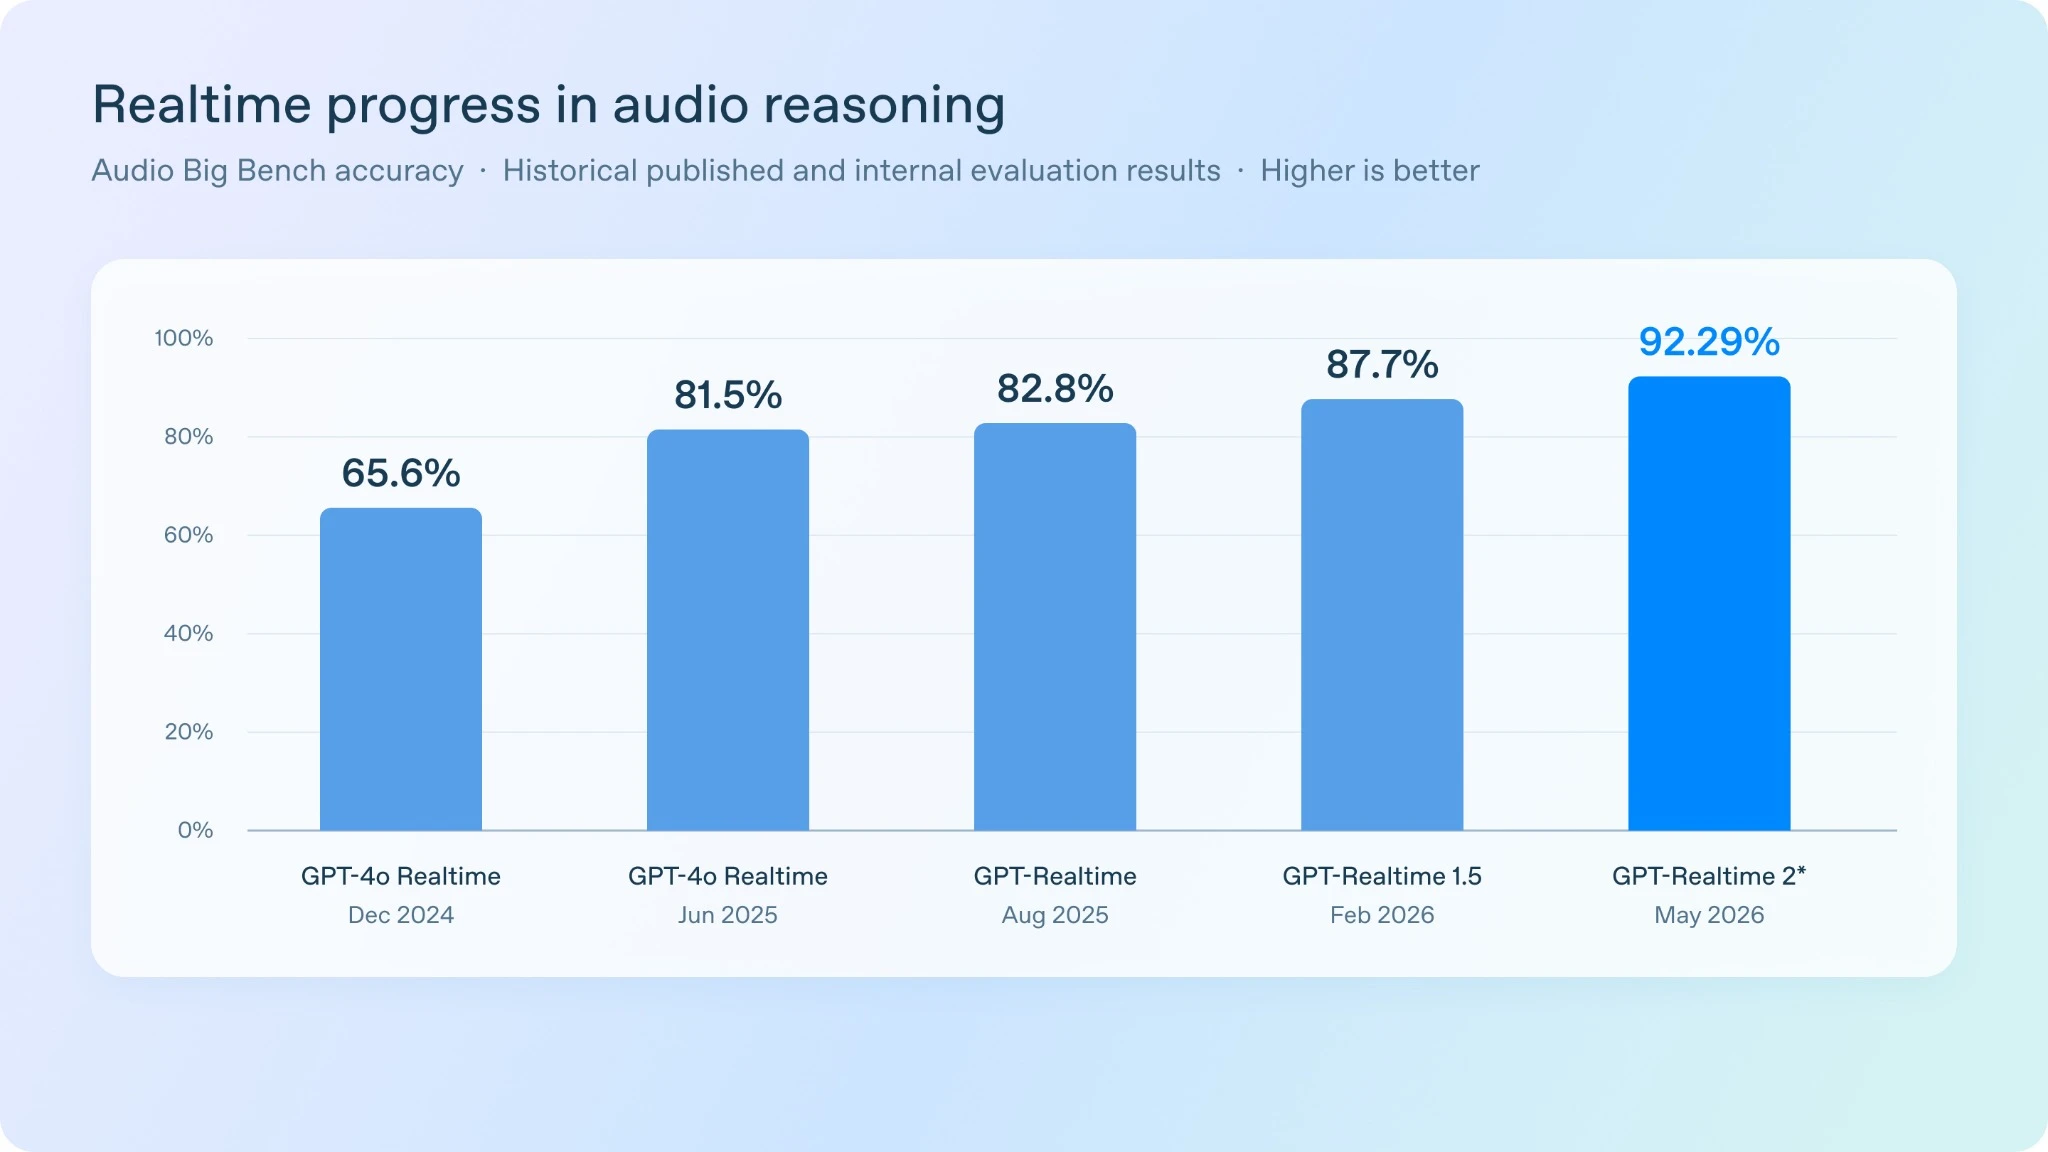
图中文字:Realtime 音频推理的进展。Audio Big Bench 准确率(历史公开结果及内部评估,越高越好):2024 年 12 月 GPT-4o Realtime 为 65.6%;2025 年 6 月 GPT-4o Realtime 为 81.5%;2025 年 8 月 GPT-Realtime 为 82.8%;2026 年 2 月 GPT-Realtime 1.5 为 87.7%;2026 年 5 月 GPT-Realtime 2 为 92.29%。图中星号沿用原图,保存的 HTML 未提供对应注释。此图展示的是跨模型版本的历史评估,不应与上文客户项目的六个月周期混为一谈。*
最终形成的语音模型,如今不仅支持这家客户的部署,也支持其他定制客服部署,以及通过 Presence 提供的托管部署。一家客户业务中遇到的问题,帮助我们找到了能够让更多客户受益的改进方向。
每一方都至关重要。客户愿意投入精力,解决一个模型当时还无法解决的问题;FDE 始终紧贴实际场景,明确问题、构建平台,并从头到尾推动合作;研究团队则提升了底层模型能力。
这就是让自己的某些工作不再必要的另一种方式:帮助把今天模型无法解决的问题,转化为未来模型可以提供的能力。我们工作的回报,超出了与任何单一客户共事的那些工时。
去寻找更难的问题
我加入 OpenAI,是为了帮助 AI 在人们的日常工作中发挥作用。这依然是团队的方向。我经常对团队说,在大语言模型开发的大多数情况下,奥卡姆剃刀原则都适用:最简单的解决方案就是最好的。在一家以前沿研究为特色的公司里,身处一个受到夸大宣传影响的行业,我们希望构建的是能够可靠运行、让一线使用者可以依赖的东西。
我们的目标,是让每一次合作都能改善后续工作的起点:让产品更容易部署,让模型能够处理更难的任务,或让下一位客户所需的定制工作更少。
如果你有一个想解决的难题,我们很愿意与你合作。如果你希望帮助解决这些问题,我们也很欢迎你加入。
那么,当 Codex 已经能够完成我们花了数月构建的工作时,我们该做什么?
去寻找更难的问题。